问 AI 一个问题,你要先等它开始回答,再等它说完。两段等待连在一起,屏幕很难告诉你,时间究竟花在了哪里。
9月16日发布的《硅谷101》,请来两位 AI 芯片创业者 Mark 和徐子扬,从 Groq、Cerebras 谈到推理芯片的设计取舍。节目让人看到,计算单元再多,也可能在等数据;数据送得更快,整套系统又可能多出别的开销。
我认为,判断推理芯片是否划算,得先给这份工作定条件:用什么模型,允许用户等多久,每天要接多少请求。芯片的成绩,最终要落到这些条件下能交付多少结果。
你在等答案,机器在等数据
模型接到一大段材料时,输入已经摆在面前,可以并行处理其中的许多 token。这一阶段叫 prefill,可以理解为先读题。随后生成答案的 decode 阶段,则需要沿着已经生成的内容往下续写。
在常见的自回归生成过程中,后一段输出依赖前面的结果。对同一个请求,机器不能像处理一批已知输入那样,任意把还没生成的内容摊开计算。并行空间收窄后,读取权重、访问已有上下文对应的数据,就可能占去很大一部分时间。
不过,瓶颈会移动。输入有多长、同时处理多少请求、使用哪种模型,都会改变这道题的答案。低批量的解码常受内存带宽限制;并发量增大,计算压力也会增加。长上下文还会带来缓存容量与访问开销。
GPU 可以把多个请求放在一起处理,分摊读取权重等开销。服务商由此提高整体吞吐,但也要处理排队、请求长短不一,以及每个用户能接受的等待时间。连续批处理允许请求动态进出。新请求可以加入,已经完成的请求退出,无需等待整批一起结束。
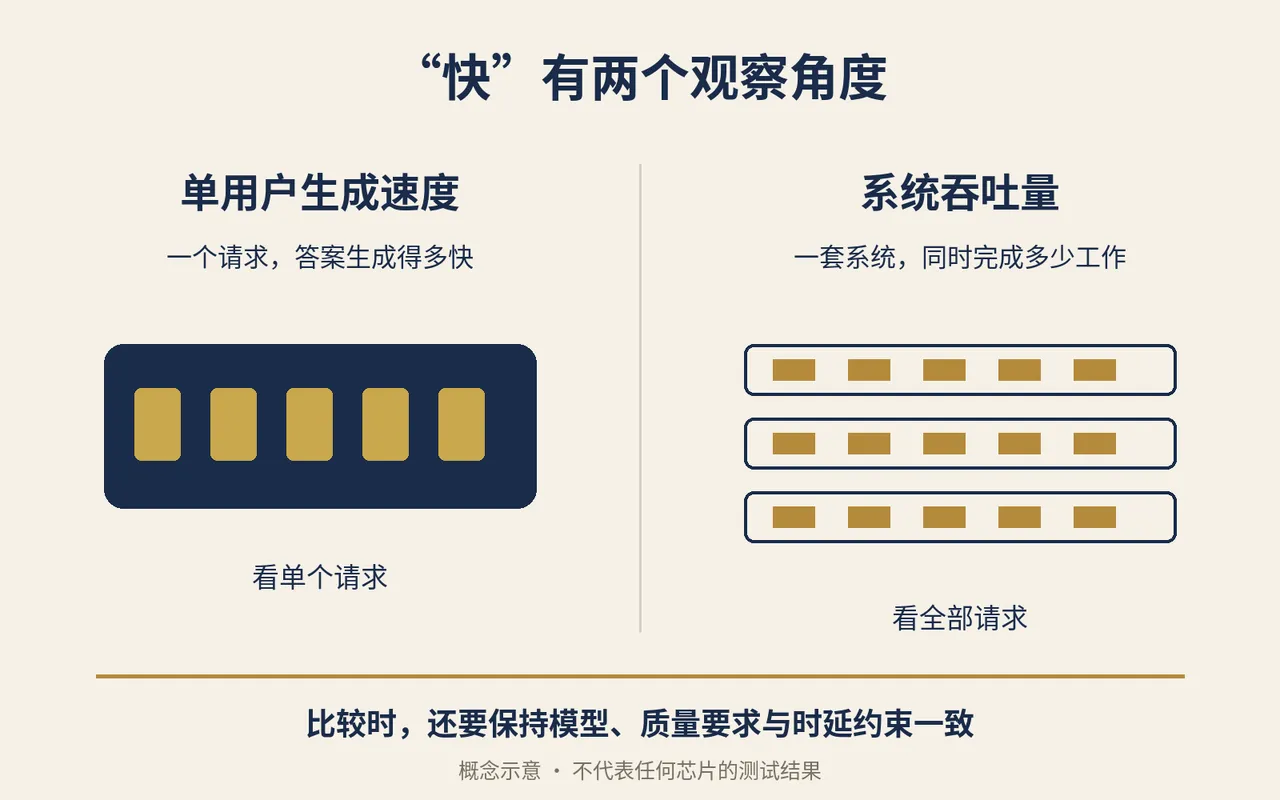
这里已经出现了两种不同的好成绩:一个用户的答案生成得快,与一套系统每秒服务更多用户。两者可以同时改善,也可能需要取舍。
我关心的是,厂商展示的速度,究竟对应哪一种工作。 同一个模型,处理短问题和长材料、服务少量用户和应付高峰流量,不能只拿一个每秒 token 数来比较。
把存储搬近,容量就成了新问题
Groq 和 Cerebras 的一个共同出发点,是让计算更容易拿到数据。
SRAM 可以做在计算芯片内部,提供高带宽访问。HBM 则是一种高带宽 DRAM,通过堆叠和先进封装等方式靠近计算芯片。两条路线都在减少数据传输的限制,但存储密度、容量和实现成本不同。
SRAM 的困难在于面积。把更多空间留给存储,就要在芯片面积如何分配上作选择。如果要让更多模型权重留在片上,而单颗芯片装不下,就需要扩大系统,把数据分布到更多资源上。压缩模型、改变存储方式也是选择,但又会带来精度或性能上的取舍。随后,芯片之间怎么通信、计算如何排布,又会影响最后的速度。
Groq 采用静态调度,把许多工作提前交给编译器,预先安排计算和数据流动,减少运行时的不确定性。Cerebras 则把大量计算核心与存储连接在晶圆尺度上,利用片上互连减少一部分跨芯片通信开销。
这两个思路都很具体,也各自增加了工程要求。前者需要编译器把模型高效地安排进系统;后者需要处理晶圆级设计的制造、供电、散热和软件问题。Cerebras 公开介绍过冗余和缺陷绕行机制:出现局部坏点,产品仍可能工作。节目尝试从缺陷比例推算制造代价,但缺少实际量产数据,这类推演还不足以还原一家公司的成本。
我的判断是,存储介质的带宽优势只能算一个起点。它能节省多少等待,系统为容纳模型、连接芯片、维持运行又花了多少代价,都要放回同一个计算范围。“数据搬得快”有机会成为成本优势,但中间隔着一整套系统。
模型更新以后,速度还剩多少
节目讨论 Groq 时,提出了静态调度与 MoE 动态路由之间的张力。
MoE 模型会根据输入选择部分专家参与计算。若专家分布在不同位置,数据要去哪里、哪些资源此刻会忙,就会影响调度。对于强调事先编排的架构,这些变化需要由编译器、模型切分和通信设计来承接。
不过,Groq 曾提供 Kimi K2 这样的 MoE 模型服务。问题应当追问到效率与实现代价,而不能仅凭“静态调度”这个标签断定它不支持 MoE。
对采购方来说,模型能够运行只是第一步。新的模型发布后,什么时候能适配?原来的速度优势能保留多少?上下文变长、专家数量改变,是否需要重新安排系统?如果团队为了使用新模型,又得维护另一套设备与软件,前一笔采购的回报就会变化。
这也是通用架构值得被认真评价的地方。它为不同任务保留的能力,可能在某项测试里显得不够精简,却能在需求变化时派上用场。专用架构则可以集中资源,把一类工作做得更好。两者的价值都取决于未来究竟要做哪些工作。
节目还谈到推理系统绕开 CUDA 的可能性。迁移的动机不难理解。性能和成本的改善值得客户尝试,但我认为,迁移难度仍要逐项验证。算子支持、调试工具、部署流程和维护经验,都关系到一套新系统能否稳定接班。更底层地使用 NVIDIA 的 PTX 指令,也仍然是在其技术体系内优化,不能据此证明已经脱离了这套生态。
模型迭代很快时,我会更看重厂商持续适配的记录。一次漂亮的演示,可以证明一个任务已经跑通;下一次模型更新,才会继续检验架构与团队留下了多少余地。
有些速度,确实值得多付钱
讨论成本,不应把低延迟的价值压低。
让 Agent 查资料、修改代码、运行测试,再根据结果继续调整,其中有些步骤前后相依。前一步迟迟不结束,后一步就无从开始。如果模型生成恰好占据了大量等待时间,推理提速就可能缩短整个任务,也可能让它在同一时限内多做几轮检查。
当然,网页加载、工具调用和测试运行也会耗时。模型更快,不保证整条流程按同样比例加速;多生成一些思考 token,也不保证答案更正确。最终仍需检查任务完成时间与结果质量。
因此,我愿意为有用的提速保留溢价空间。一项必须及时完成的工作,早一些给出合格结果,本身就有价值。若只是夜间批量处理材料、第二天早上交付,单条请求再快一点,可能远没有单位成本重要。
NVIDIA 的推理成本指南,把时延约束和峰值请求量列为估算资源需求的前提,也区分了单用户速度与系统吞吐。这个顺序更接近采购者的处境:先看服务要做到什么程度,再看需要部署多少资源。测试里的一项速度成绩,还不足以交代完成这些工作的总成本。
对买方而言,可以把问题问得更直接:同样的任务和质量要求下,我多付的钱,换来了多长时间、多少额外工作,或者什么原来做不到的服务?如果答案清楚,快而稍贵也可能是好买卖。
买的是系统接下来几年的工作
两位嘉宾在节目中强调,推理最终要算到 token 的生产成本。我赞同这个方向,也会在分母上再加一道限制:应当比较满足既定质量与时延要求的产出。
压低精度、改变模型,或者让请求等得更久,都可能让数字变好看。如果这些变化已经影响用途,单看每百万 token 的价格,就会把不同的服务误认为同一种商品。
采购设备的投入、电力与散热、软件适配和运维,需要在一致的使用周期里计算。预期的业务量也要接受检验。系统满载时很漂亮的单位成本,在长期闲置时未必还成立;只看低负载下的单用户速度,又可能低估它应付高峰的困难。
所以我更愿意要求一份贴近真实业务的测试:常用模型与输入输出长度都不变,从平时负载跑到高峰,既看完成了多少工作,也看哪些请求等得过久。再把适配新模型所需的时间、人员和系统限制,一起写进采购判断。
快、省、通用的边界也会移动。架构、工艺和软件都可能改善取舍,同一个系统也可以让不同硬件分工。可是在某次具体采购里,资源与时间总有约束,厂商必须说明自己优先解决了什么。
推理芯片是否划算,要由它接得住的工作来证明。 屏幕上的字冒得更快,值得高兴;真正决定是否换掉旧系统的,是它能否在你允许的等待时间内,持续交付可靠结果,并让几年后的总账仍然说得通。
收听《硅谷101》E251,点击阅读原文。
留言